Die technische Landschaft für Hochleistungssysteme wird durch die Interaktion komplexer Hardwarearchitekturen und optimierter Softwarestacks definiert. Die Performance eines Systems ist kein isolierter Wert, sondern das Ergebnis eines präzisen Zusammenspiels von Komponenten, deren Effizienz und Skalierbarkeit kontinuierlich weiterentwickelt werden. Dieser Artikel analysiert die Schlüsselprinzipien moderner Systemdesigns, von der Mikroarchitektur bis zur Gesamtsystemintegration, und beleuchtet die zugrundeliegenden Technologien, die maximale Rechenleistung und Energieeffizienz ermöglichen.
CPU-Mikroarchitektur und Parallelverarbeitung
Moderne Prozessoren wie AMDs Ryzen 7000-Serie oder Intels Core der 14. Generation basieren auf einer ausgeklügelten Mikroarchitektur, die Instruktionen parallel verarbeitet. Kernelement ist die Out-of-Order-Execution (OoOE), die Befehle dynamisch neu anordnet, um Pipelinestalls zu vermeiden und die Auslastung der Ausführungseinheiten zu maximieren. Gleichzeitig erfordern immer höhere Taktraten, die die 6-GHz-Marke überschreiten, fortschrittliche Fertigungstechnologien wie TSMCs 4nm- oder 5nm-Prozess. Die Leistungsaufnahme (TDP) solcher Chips bewegt sich in einem Bereich von 65W bis über 250W für Extreme-Performance-Modelle, wobei präzise Spannungsregelung und fortschrittliche Kühlung kritisch sind. Die parallele Verarbeitung wird durch Threading-Technologien wie Simultaneous Multithreading (SMT) oder Intels Hyper-Threading weiter gesteigert, die jedem physischen Kern erlauben, mehrere Instruktionsströme zu verwalten und so die Systemressourcen besser auszulasten.
Speicherhierarchie und Latenzreduktion
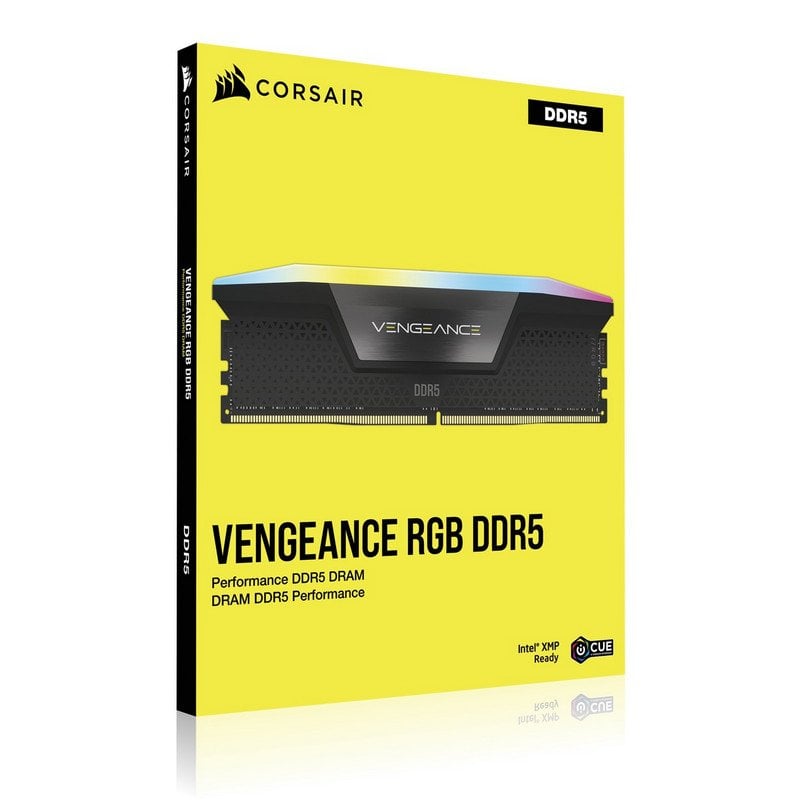
Die Geschwindigkeit der CPU wird maßgeblich durch die Effizienz der Speicherhierarchie bestimmt. Zwischen den schnellen Registern im Prozessorkern und dem vergleichsweise langsamen Hauptarbeitsspeicher (RAM) dienen mehrere Cache-Ebenen als Puffer. Der L1-Cache, typischerweise 64KB pro Kern, bietet die geringste Zugriffslatenz von unter 1 ns, ist jedoch begrenzt. Der L2-Cache, mit mehreren hundert Kilobyte bis Megabyte pro Kern, fungiert als Zwischenspeicher, während der große, gemeinsam genutzte L3-Cache (oft 32MB bis 128MB) die Koordination zwischen den Kernen übernimmt. Die Leistung des RAM-Subsystems, getrieben von DDR5-Technologie mit effektiven Taktraten von 5600 MT/s bis 8000 MT/s und mehr, wird durch Speichercontroller und -routing auf dem Mainboard (PCB) optimiert. Niedrige CAS-Latenzen (z.B. CL36) und eine hohe Transferbandbreite sind entscheidend für datenintensive Anwendungen wie Videobearbeitung oder wissenschaftliche Simulationen.
| Komponente | Typische Größe | Zugriffslatenz | Technologie-Beispiel |
|---|---|---|---|
| L1 Cache (pro Kern) | 32-64 KB Instruktion, 32-64 KB Daten | < 1 ns | Dedizierte SRAM-Strukturen |
| L2 Cache (pro Kern/Cluster) | 512 KB – 2 MB | ~ 3-10 ns | Größere SRAM-Blöcke |
| L3 Cache (gemeinsam) | 16 MB – 128 MB+ | ~ 10-30 ns | Chip-weite intelligente Cache-Architektur |
| DDR5 RAM | 16 GB – 64 GB pro Modul | ~ 70-100 ns | DDR5-5600 bis DDR5-8000, Dual-Channel |
Grafikprozessoren und Beschleuniger-Hardware
Grafikprozessoren (GPUs) von NVIDIA (GeForce RTX 40-Serie), AMD (Radeon RX 7000) und Intel (Arc Serie) haben sich von reinen Rendering-Engines zu universellen Parallelrechnern entwickelt. Ihre Stärke liegt in der massiv parallelen Verarbeitung tausender Threads durch Streaming-Multiprozessoren (SMs) oder Compute Units (CUs). Spezielle Hardware-Beschleuniger sind für bestimmte Workloads integriert: NVIDIA integriert RT-Cores für Raytracing-Beschleunigung und Tensor Cores für KI-Inferenz und DLSS, während AMD ähnliche Funktionen über Ray Accelerators und AI Accelerators in seinen RDNA-3-GPUs bereitstellt. Die Leistung wird durch Speicherbandbreite limitiert, die moderne GPUs durch schnellen GDDR6X- oder HBM-Speicher mit Bandbreiten von über 1 TB/s adressieren. Diese Architekturen sind grundlegend für Echtzeit-Rendering, maschinelles Lernen, Molekulardynamik-Simulationen und Kryptografie.
PCIe-Gen4/Gen5 und System-Interkonnekt
Die Peripherie Component Interconnect Express (PCIe)-Schnittstelle ist das Rückgrat der Systemkonnektivität. Der Übergang von PCIe Gen 4 (16 GT/s pro Lane, ~2 GB/s) zu PCIe Gen 5 (32 GT/s, ~4 GB/s) verdoppelt die verfügbare Bandbreite für kritische Komponenten wie Grafikkarten und NVMe-SSDs. Dieser Fortschritt reduziert Engpässe bei der Datenübertragung zwischen CPU, Chipsatz und angeschlossenen Geräten erheblich. Moderne Chipsätze, wie AMDs X670E oder Intels Z790, orchestrieren diesen Datenverkehr und bieten zahlreiche High-Speed-I/O-Lanes für Speicher, USB4-Ports (mit bis zu 40 Gbps) und Netzwerk-Controller (2.5GbE, 10GbE). Eine effiziente Lane-Zuteilung durch die System-Firmware (UEFI/BIOS) ist entscheidend, um die volle Leistung aller installierten Hochgeschwindigkeitskomponenten gleichzeitig zu nutzen.
Kühlung und thermisches Design
Die Abführung von Verlustleistung ist eine zentrale Herausforderung im Systemdesign. Luftkühler mit großen Heatpipes und Kühlkörpern sowie All-in-One-Wasserkühlungssysteme (AIOs) mit 240-mm- oder 360-mm-Radiatoren sind Standard. Die Effizienz wird durch die Wärmeleitfähigkeit der Thermal Interface Material (TIM), die Durchflussrate der Kühlflüssigkeit und die statischen Druckwerte der Lüfter bestimmt. Für extreme Performance-Szenarien, wie Übertaktung oder Serverbetrieb, kommen custom Wasserkühlungs-Schleifen oder direkte Die-Kühlung ins Spiel. Das thermische Design Power (TDP) eines Prozessors gibt die unter Last abzuführende Wärmeleistung an, die effektive Leistungsaufnahme (PPT) kann jedoch deutlich höher liegen, was eine entsprechend dimensionierte Kühllösung und Netzteilkapazität erfordert.
Performance-Metriken und Benchmarking
Die objektive Bewertung der Systemleistung erfolgt durch standardisierte Benchmarks. Synthetische Tests wie Cinebench R23 (CPU-Rendering), 3DMark Time Spy (Gaming) oder PCMark 10 (Alltagsleistung) liefern reproduzierbare Scores. Reale Workload-Benchmarks, etwa das Rendern eines Projekts in Blender, das Kompilieren von Code oder das Transcodieren von Videomaterial mit HandBrake, bieten praxisrelevante Performance-Daten. Die Interpretation dieser Ergebnisse erfordert ein Verständnis der getesteten Subsysteme: Ein CPU-lastiger Benchmark zeigt die Effizienz der Kernarchitektur und des Cache, während ein GPUaaa-lastiger Test die Shader-Leistung und Speicherbandbreite auslastet. Die Analyse der Frames-per-Second (FPS) in Spielen bei verschiedenen Auflösungen (1080p, 1440p, 4K) offenbart, ob das System durch die CPU oder die GPU limitiert wird.
| Benchmark-Typ | Beispiel-Tool | Primär getestetes Subsystem | Typische Metrik |
|---|---|---|---|
| Synthetisch (CPU) | Cinebench R23, Geekbench 6 | CPU (Multi-/Single-Core) | Punkte (pts), Punkte pro Watt |
| Synthetisch (GPU/Gaming) | 3DMark Time Spy, Port Royal | GPU, Raytracing | Graphic Score, FPS-Durchschnitt |
| Real-World (Produktivität) | PCMark 10, SPECworkstation 3 | Gesamtsystem, I/O | Gesamtscore, Zeit bis zum Abschluss |
| Real-World (Content Creation) | Blender BMW27, HandBrake | CPU/GPU-Rendering, Encode | Renderzeit in Sekunden |
Energieeffizienz und Performance-per-Watt
Die reine Spitzenleistung wird zunehmend durch die Metrik der Performance-per-Watt ergänzt. Architekturen wie AMDs Zen 4 oder Apples M-Serie-Chips demonstrieren, dass eine durchdachte Mikroarchitektur und fortschrittliche Fertigung (5nm, 3nm) hohe Rechenleistung bei moderater Leistungsaufnahme ermöglichen. Das Power-Management des Systems, gesteuert durch die CPU-Internal Power States (P-States, C-States) und die Mainboard-Firmware, regelt Taktfrequenz und Spannung dynamisch basierend auf der Auslastung. Effiziente Netzteile (PSUs) mit 80 Plus Platinum- oder Titanium-Zertifizierung minimieren Stromverluste bei der Wandlung. Diese Optimierungen sind nicht nur für mobile Geräte und Laptops entscheidend, sondern auch für Rechenzentren, wo die Gesamtbetriebskosten (TCO) direkt von der Energieeffizienz der Hardware abhängen. Die fortschreitende Miniaturisierung und die Integration spezialisierter Beschleuniger werden diesen Trend weiter vorantreiben.